For en del år siden var jeg rådgiver for en stor offentlig organisation, som løbende gennemførte service og vedligehold på materiel med en samlet værdi på mange milliarder kroner.
Grundlæggende var vedligeholdelsen opdelt i to kategorier: planlagt vedligehold og uplanlagte reparationer.
Den planlagte vedligeholdelse blev gennemført af både sikkerhedsmæssige og økonomiske årsager. Den uplanlagte vedligeholdelse opstod derimod, når noget gik i stykker eller krævede reparation tidligere end forventet.
Og det var naturligvis den sidste kategori, der gav de største udfordringer.
For hvordan sikrer man, at de rigtige reservedele er på lager, når man ikke ved, hvad der går i stykker? Og hvordan sikrer man, at de nødvendige ressourcer og faglige kompetencer er til rådighed på det rigtige tidspunkt?
I praksis blev meget af dette håndteret kvalitativt og med en god portion Fingerspitzengefühl. Det fungerede til en vis grad, men resultatet var også, at man jævnligt manglede enten reservedele, ressourcer eller begge dele.
Kan det uplanlagte gøres mere planlagt?
Det interessante spørgsmål blev derfor:
Kunne vi gøre en del af det uplanlagte vedligehold mere forudsigeligt?
Vi begyndte med at anlægge et mere kvantitativt perspektiv og tog udgangspunkt i organisationens eksisterende klassifikationer af fejltyper.
Tanken var egentlig ganske enkel. Hvis vi kunne finde systematiske mønstre i, hvornår forskellige fejl opstod, kunne vi måske også prognosticere, hvor mange fejl af de enkelte typer der ville opstå hen over året.
Og hvis det var muligt, kunne prognoserne direkte omsættes til to meget konkrete ting:
- forventet behov for reservedele på lager
- forventet ressourcetræk, både i antal timer og i nødvendige faglige kompetencer
Fra erfaring til matematisk model
Næste skridt var derfor at undersøge, om historiske fejlregistreringer kunne anvendes i egentlige matematiske prognosemodeller.
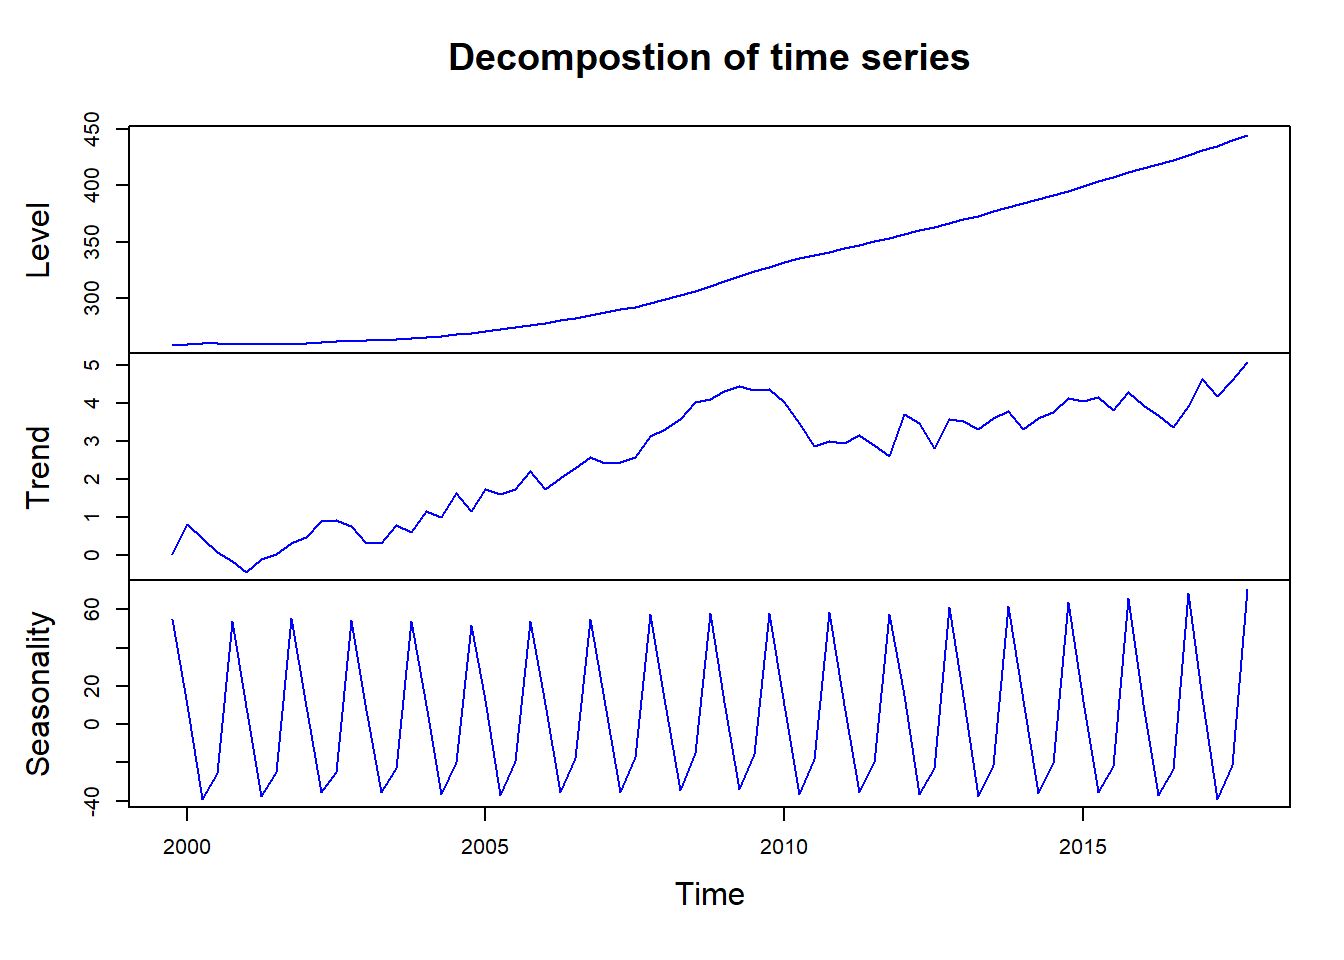
Vi valgte blandt andet Holt-Winters-modellen, en klassisk tidsrækkemodel, der løbende tilpasser sig nye observationer og kan modellere niveau, trend og sæsonvariation.
Via parameterstyret eksponentiel udglatning får nyere observationer større betydning end ældre observationer. Modellen kan derfor gradvist tilpasse sig, hvis mønstret i data ændrer sig.
I moderne terminologi ville mange uden tøven placere denne type modeller under den brede AI-paraply er kaldes ML (Machine Learning), men på daværende tidspunkt betragtede vi dem mere nøgternt som avancerede statistiske prognosemodeller.
Og skepsissen var betydelig.
Kan man virkelig forudsige fejl?
Bliver prognoserne ikke alt for usikre?
Er erfarne planlæggere ikke bedre til det?
Der var kun én fornuftig måde at afgøre det på: at teste modellerne mod virkeligheden.
Resultaterne var overraskende gode
Vi anvendte de historiske data til at generere prognoser og sammenholdt efterfølgende prognoserne med de faktisk realiserede fejl.
Modellerne ramte overraskende fornuftigt.
Især var de gode til at identificere sæsonvariationer og trends, hvor nogle fejltyper viste sig at være tæt korrelerede med blandt andet vejr- og temperaturforhold.
For de fejltyper, der blev testet, lå prognosenøjagtigheden i størrelsesordenen 75-90 %.
Men der var fortsat skepsis.
Så vi lavede et meget simpelt tankeeksperiment.
Fra 50 % til 87,5 % planlægningsbar vedligeholdelse
Antag for enkelhedens skyld, at:
50 % af vedligeholdelsen er planlagt 50 % af vedligeholdelsen er uplanlagt
Hvis vi kan prognosticere 75 % af den uplanlagte vedligeholdelse, får vi:
50 % + (50 % × 75 %) = 87,5 %
Det betyder naturligvis ikke, at 87,5 % af vedligeholdelsen pludselig bliver planlagt vedligehold i klassisk teknisk forstand.
Men 87,5 % bliver i princippet planlægningsbar.
Man kan i langt højere grad forudse behovet for reservedele, bemanding og specifikke kompetencer. Og dermed reducere konsekvenserne af den usikkerhed, der normalt følger med uplanlagte reparationer.
Det var faktisk en ret vild mental erkendelse.
For spørgsmålet var ikke længere, om modellen kunne forudsige hver enkelt fejl perfekt.
Det interessante var, om den var tilstrækkelig præcis til at skabe forretningsmæssig værdi.
Og det viste den sig at være.
Og det er her, moderne AI bliver rigtig interessant
Denne type kvantitative modeller er ikke nye. Det nye er de muligheder, der opstår, når de kombineres med moderne AI og machine learning.
Klassiske tidsrækkemodeller kan være særdeles effektive, når data indeholder relativt stabile mønstre i niveau, trend og sæson.
Moderne machine-learning-modeller kan supplere dem ved at analysere langt flere faktorer samtidigt og identificere sammenhænge, som ikke nødvendigvis er lineære.
Det kan eksempelvis være sammenhænge mellem fejl og:
- temperatur og øvrige vejrforhold
- belastning og anvendelsesgrad
- materiellets alder
- historiske reparationer
- komponenttype
- driftsmønstre
- leverandører og reservedelstyper
Dermed bevæger man sig gradvist fra:
reaktion → prognose → egentlig prædiktion og optimering.
Og det er måske den vigtigste pointe.
Michael K. Kærgaard
📞 +45 28 40 20 09
📧 kontakt@aintelligence.dk
🌐 www.aintelligence.dk
Skriv et svar